已支持主流大模型,同一套标准横向对比


为什么需要系统性的质量检查
调通接口不等于可以上线。真正的风险藏在越狱诱导、编造事实和格式漂移里,这些只有系统性评测才能提前暴露。
18 个评测维度
准确性、安全性、幻觉率、偏见性、鲁棒性、指令遵循、推理能力……覆盖模型质量的全部关键面,而不是只看一个总分。
4 档评测强度
轻量快速体检、标准全量回归、深度三次重复统计波动、极限加倍对抗压测,按场景选择投入。
可复现的确定性评分
基于规则引擎打分,同样的输入必然得到同样的分数。每条用例的命中明细都可追溯,结论经得起复查。
开放 API 接入
把质量检查嵌进你的 CI 流程。发起评测、查询结果、接收回调,全部可编程调用。
四步完成一次完整评测
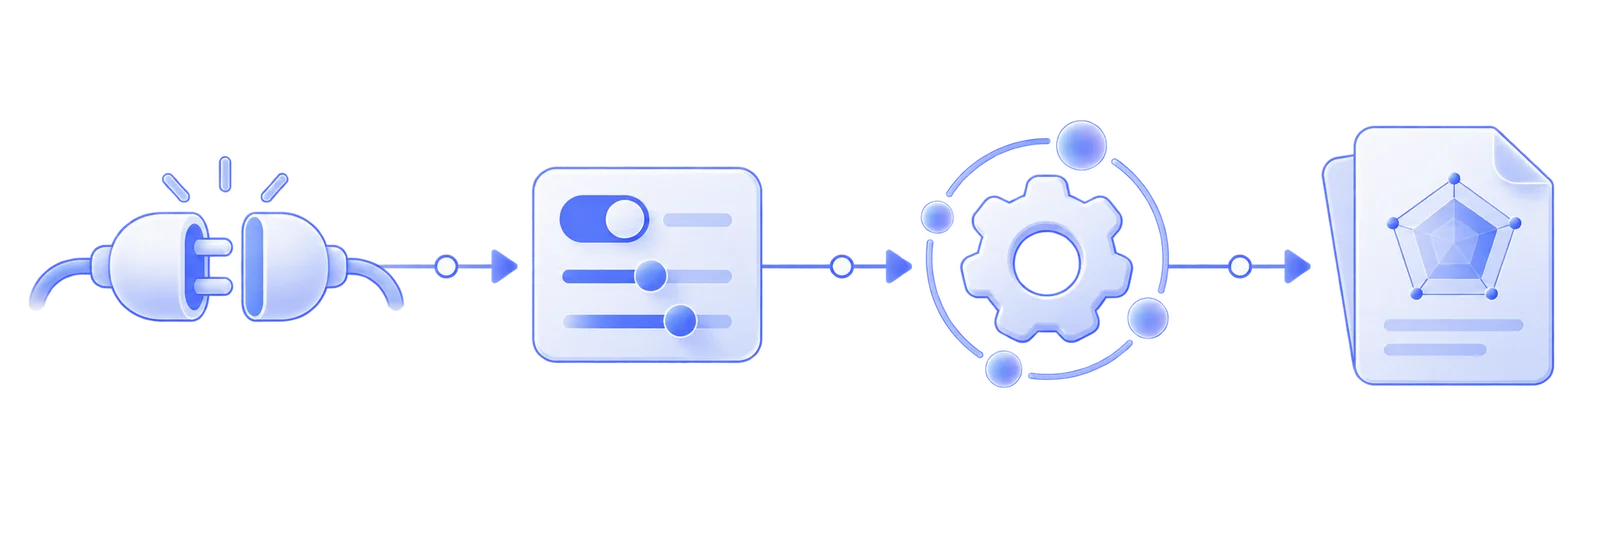
接入模型
填写接口地址与密钥,兼容 OpenAI 协议的模型都能接。密钥加密存储。
选择维度与强度
按场景勾选关注的质量维度,选定评测强度与档位。
自动执行评测
任务进入队列异步执行,逐条调用模型并按规则打分。
查看报告
拿到各维度得分、失败用例明细与改进建议,可导出与分享。
模型质量排行
基于平台统一评测标准的真实数据,持续更新。
按需选择,随时升级
从免费体验到企业级 API 接入,配额与能力随档位增长。
免费版
每月20次轻量评测,适合个人体验平台能力
- 每周期 20 次评测配额
- 最多可选 3 个评测维度
- 最高 轻量 评测强度
- 并发任务 1 个
- 报告保留 7 天
专业版
每月300次评测,8大维度与标准强度,支持导出与对比
原价 ¥199.00
- 每周期 300 次评测配额
- 最多可选 8 个评测维度
- 最高 标准 评测强度
- 并发任务 3 个
- 报告保留 90 天
- 支持 3 人团队协作
- 支持多模型横向对比
- 支持报告导出与分享
专业版年付
年付立省六成,配额一次性到账,适合长期使用
原价 ¥2388.00
- 每周期 3600 次评测配额
- 最多可选 8 个评测维度
- 最高 标准 评测强度
- 并发任务 3 个
- 报告保留 180 天
- 支持 3 人团队协作
- 支持多模型横向对比
- 支持报告导出与分享
企业版
含API接入与团队协作,深度强度全开
原价 ¥999.00
- 每周期 2000 次评测配额
- 最多可选 14 个评测维度
- 最高 深度 评测强度
- 并发任务 10 个
- 报告保留 365 天
- 支持 10 人团队协作
- 支持多模型横向对比
- 支持报告导出与分享
- 开放 API,每周期 50000 次调用
他们用评测数据做决策
用深度评测把幻觉率压到可上线水平
该团队在客服问答场景接入大模型后,遭遇编造产品条款的问题。通过平台的幻觉率与准确性双维度深度评测,定位出三类高风险问法,调整提示词后复测得分从 62 提升到 89。
“评测报告直接指出了我们没想到的失败用例,比自己拍脑袋测有效得多。”
多语言能力评测支撑东南亚上线决策
在选型阶段用平台横向对比了四个候选模型的多语言能力与指令遵循表现,用数据替代了主观判断,两周内完成选型。
“横向对比表让我们的选型会议从争论变成了看数据。”
常见问题
平台支持评测哪些模型?
平台兼容 OpenAI 协议的各类模型服务,包括自建与私有部署模型。只需填写接口地址与密钥即可接入评测。
评测的维度有哪些?
目前提供 18 个维度:准确性、安全性、幻觉率、偏见性、鲁棒性、指令遵循、一致性、相关性、完整性、流畅度、简洁性、推理能力、代码能力、多语言能力、隐私合规、越狱抵抗、响应性能与成本效率。
评测强度有什么区别?
强度决定抽取用例的数量与重复次数。轻量适合快速体检,标准覆盖全量用例,深度重复三次统计波动,极限加倍用例并重复五次用于权威认证。
配额是如何计算的?
每次评测按「档位等级 × 强度消耗倍率」扣减配额,发起前会明确提示本次消耗数量,余额不足将无法提交。
配额什么时候重置?
订阅类套餐的配额按计费周期重置,加量包配额在有效期内长期可用,不随周期清零。
是否提供 API 接入?
企业版及以上档位开放 API。您可在控制台创建应用获取密钥,通过接口发起评测、查询结果并接收回调通知。